准确率 90%?口径没定,数字无效
Agent验收上最尴尬的一幕,常常跟效果好不好没关系。是双方对「好」这个字的理解,压根没统一过。
业务方准确率多少。开发答90% 以上。业务再问怎么算的。乙方开始讲评测集、模型、讲检索、讲幻觉控制。十分钟后,会议纪要上写下一句真实效果待进一步验证。
我做过几个企业问答类 Agent 的项目,这个坑也踩过。踩完之后留下一个判断,Agent验收的第一步是先把口径定死,急着开测没用。口径不定清,测出来的数字都是无效的。
下面就分享一下我之前在做实际企业级项目过程中对测试口径,指标分层,协作机制设立的一些思路和想法:
一、大多数的准确率其实扛不住追问
印象最深的是某行的智能问答 Agent。它接了 2 万份以上制度、手册和 FAQ 文档,上线前跑过一轮完整测试,测试集覆盖 6 个业务部门。结果是这样分布的
最高 97.1%,最低 44.8%,差了三倍多。
要是我在验收会上只报一个平均 85%,业务方听起来是的是还不错,可个人部的用户实际感受是问三次对一次半。同一个数字,在报告里是漂亮的,在现场是灾难的。
所以我后来改了说法。被问准确率,报分布,不报平均数。
分部门看是 52% 到 97%,成熟的公司部场景 97.1%,但多轮对话只有 44.8%,那是我单独立项要优化的短板。
这句话比「90%+」多说了三件事,成熟场景是能打的,问题集中在多轮,而我知道问题在哪。
给总数会掩盖最大的问题。分布才能指导行动,它告诉我该先修哪个部门。
二、”答对“和”引用对“,是两件事
第二个坑更难发现,因为它不报错。
一开始我们的判定维度只有一个,回答跟预期答案是否一致。跑完一轮发现有一批用例被判成“一致”,可去复核来源,引用的文档片段跟标准答案不是同一份。
这就出现了一种很尴尬的状态。回答看着是对的,实际的切片引用是错的,这可能对于普通的问答场景来讲可以被容忍,但是对某来说这就严重不符合其业务需求。
在企业问答场景里,这种状态比答错更危险。答错用户会怀疑,引用错了,用户会照着错的依据去执行。银行、保险、法务这类强合规、强监管行业的场景,答案的可追溯性有时候比答案本身更重要。
后来我们把判定拆成两个独立维度。
| 维度 | 判定档位 |
|---|---|
| ① 回答是否一致 | 回答一致 / 部分一致 / 不一致 |
| ② 答案来源文件片段是否一致 | 文件一致 / 部分一致 / 不一致 |
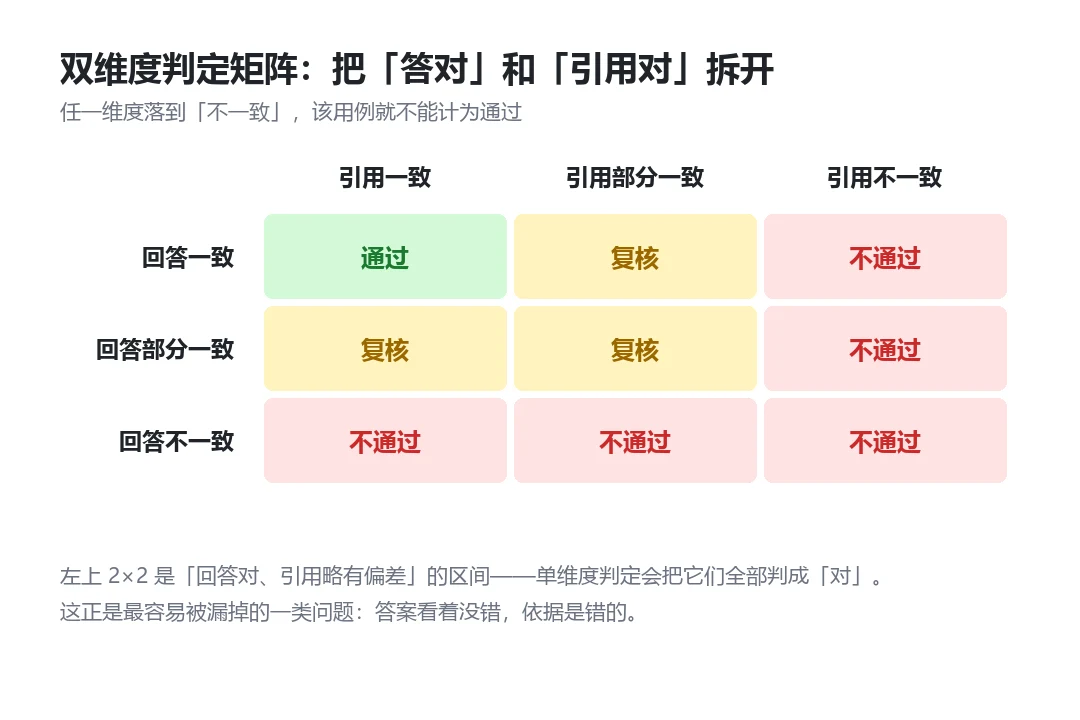
拆开之后,那批回答对、引用错的用例立刻从「通过」里掉出来,变成了可以归因的坏例。
行业里也是这么分的。企业级 RAG 评估里有一项叫引用伪造测试(citation fabrication),专门检测编造的引用和元数据。理由很直白,编造引用在演示环境里根本测不出来,演示的时候没人去翻一个个翻阅冗长的原文。
把答对和引用对拆成两个独立判定项,是验收设计里最容易被漏掉、又最值钱的一条。
三、最危险的一条,做系统的人给自己打分
前两个坑都还能靠技术补。第三个坑是机制问题。
我见过最常见的验收失败,起因几乎都是判定权没交出去。
部分一致算不算通过这个问题,开发方回答不了。这跟技术没关系,是业务容忍度的问题。同一个回答,客服场景下算部分一致、可用,因为未产生误导信息且答案结果准确。合规场景下可能算不一致、必须重写。这个判断只有业务能下,也只能业务来下。
我自己的做法是明确分工。
- 我把判定维度设计出来、把测试集组织好、把统计做出来
- 判定权交给业务和测试同学
- 我不既做系统,又给自己的系统打分
四、定口径只需要回答三个问题
口径这件事,说到底就是三个问题的答案。
第一问,一模一样算对,还是要点一致算对。
这取决于业务容忍度,没有标准解。一般的客服场景下,答案覆盖了要点、表达不同,就算对。合规场景下,措辞本身就是风险,必须逐字比对。同一套系统,两种口径测出来的准确率数字能差二十个点。
第二问,谁来判。
上一节说过,判定权归业务侧,开发侧只负责把判定维度设计好。
第三问,分母是谁,测试集多大。
这条最容易被含糊过去。说准确率 90%,一定要能接上在多少条测试集上、口径是什么。接不上,这个数字就不可复算。能执行、能复测、能写进合同的字才是准确率的标准。
五、用分布回答,别用平均数回答
口径定完,接下来是测试集怎么搭。有三件事要做:
第一、分部门、分渠道取数,不混要混为一谈。
前面那张表就是结果。不同部门的语料质量、问题复杂度、用户表达方式都不一样,混在一起算总分,等于把强弱差异全抹平了。
顺便说一个更有价值的发现。我们把多轮和单轮分开统计之后,看到一组数字,单轮 74.0%,多轮 44.8%。再往下拆,多轮场景里「回答不一致」占到 34.5%,查看系统日志后发现主要的失效模式是指代消解。用户说那这个呢,系统不知道这个指什么。
第二、测试集得拆成固定集和动态集。
我们后来用的配比是 70% 固定测试集加 30% 生产环境动态测试集。固定集负责遍历典型场景、边界场景、异常场景,保证每次评测可比。动态集从真实生产问题里取,负责规避模型拟合。
这 30% 为什么必须留,因为固定测试集有个天然缺陷,题是我出的,答案也是我标的。时间一长,模型在固定集上表现很好,真实用户一用就露馅,这就是要规避Agent的过拟合。这个比例没有标准答案,是在可控和真实之间找的一个平衡,三七开只是行业的通用经验。
第三、badcase 要能落到具体类别上。
归因如果只写”回答错误“,等于没归因。我们最后用的是五分类,没有找到源文件 / 没有找到源文件但存在两个版本 / 没有找到对应文本块 / 召回的文本块里有答案但模型没答对 / 抽取的 QA/FAQ 对本身有问题。
这五类分别指向不同的修法。前两类是知识治理问题,中间两类是检索问题,最后一类是数据加工问题。分类的颗粒度,决定了修复动作能不能落到具体的事或负责人上。
六、没有拒答负例,正确率就是虚高的
问答 Agent 的测试集里,最容易被漏掉的是拒答负例。也就是用户问了一个知识库里没有的问题,系统该不该承认自己不知道。
我这儿有个不太好看的数字。在一个本地知识库客服项目里,实测拒答倾向正确率只有 1/5,也就是 20%,没达标。
根因我定位到两条。一条在样本侧,拒答测试用例只有 5 条,还是我按想象写的,没有真实用户那种刁钻问法。另一条在提示词侧,我只写了基于切片回答,没写切片里没有就明确说不知道,模型倾向于用它的先验知识硬答。
两条叠在一起,结论就是一条负例都没有的系统,等于没有拒答能力。
还有一个容易混的地方,值得单独说清。「低置信度就拒答」和「该拒答的场景有没有拒答」,是两件不同的事。
| 类型 | 机制 | 难度 |
|---|---|---|
| 规则的拒 | 置信度低于阈值就引导澄清、拒绝回答 | 设阈值即可做到 |
| 判断的拒 | 判断这个问题是否超出了知识边界 | 需要真实的边界负例集 |
前者是工程配置,后者是能力问题,前者可以通过workflow的设计来规避,后者需要从节点提示词、知识库检索、拒答判例等多个角度来入手。
七、总结
回到开头那句:Agent 验收的第一步是把口径定死,急着开测没用。
拆开就三件事:口径怎么定、判定权给谁、分母是谁,接不上就不可复算。责任方必须在开测前落定,下次验收会别急着排测试计划,把Agent准确率从一个形容词,变成能复测、能写进合同的数字。