自己跑得通,不算交付
我把一个评测脚本调通了,本地跑得干干净净。交给同事那天,他装依赖就卡住了,第三步报错,第四步的输出结果和我这边对不上。
那一刻我才明白,自己之前做的大部分项目,都停在给自己用这一步。
下面分享一下我在开发skill的过程中,为了“交付skill”做了什么:
一、先要回答的,是这算不算交付
这件事不考Coding能力,考的是交付意识。你写的是留给自己用,还是准备交出去。
做 AI FDE 的人对这一点体会最深。这类工作的日常,是把能力装进客户的真实环境,让它在那边转起来。演示环境调得再漂亮,也只是演示。行业里对这类工作的定义反复落在同一句话上,在客户环境里写生产代码,并对上线之后的结果负责。能力到不了现场,前面的工作都不作数。
更现实的一点是,客户环境和你本机从来不是同一套环境。数据形状不同,权限边界不同,依赖版本不同,网络出口也不同。你在自己机器上积累的操作习惯,到那边基本清零。
所以我先立的不是措施,是目标。换一台机器、换一个人,照着我的文档,能跑出和我一样的结果。
这个目标立住了,后面的动作才有落点。它同时排除两种状态,一是我这台机器上能跑,二是我大概记得怎么跑。这两种都不算交付。
换个角度看,这句话的门槛很高。自用的版本允许保留隐性知识,你的本地Agent根据memory知道哪个参数要手改,也知道先起哪个服务。交付不允许隐性知识,接手的人不知道你的Agen知道什么。
二、四道措施,各管一个失效点
可复现要落到四个动作上。少做一道,就有一类人跑不起来。表格末行是附带动作,不在主线。
第一道:凭据零明文:配置文件里只允许出现凭据的变量名,值一律不进仓库。任何智能体都不许接收、输出、记录密钥明文。手机号、卡号一旦进日志就收不回来。代码可以回滚,泄露不能。这条规则拦截的是最常见的一类事故,程序运行正常,仓库和日志里却躺着明文。
第二道:依赖版本冻结解决的是环境问题。我记录实测的版本签名,把「文档写的」和「实际库里的」逐条对照,差异照实记下来,也不回头把它改齐。原因很直接,文档和库的真实行为不一致是常态,把差异抹平等于把风险转给接手的人。我自己踩过一次,Python 3.13 装不上 ragas,版本差一步,连安装都过不去。类似的事在社区里也不新鲜,有人分享的工作流包,换个账号导入就报请安装缺失的包。根因不是对方不会用,而是那个包依赖了平台未预置的库。
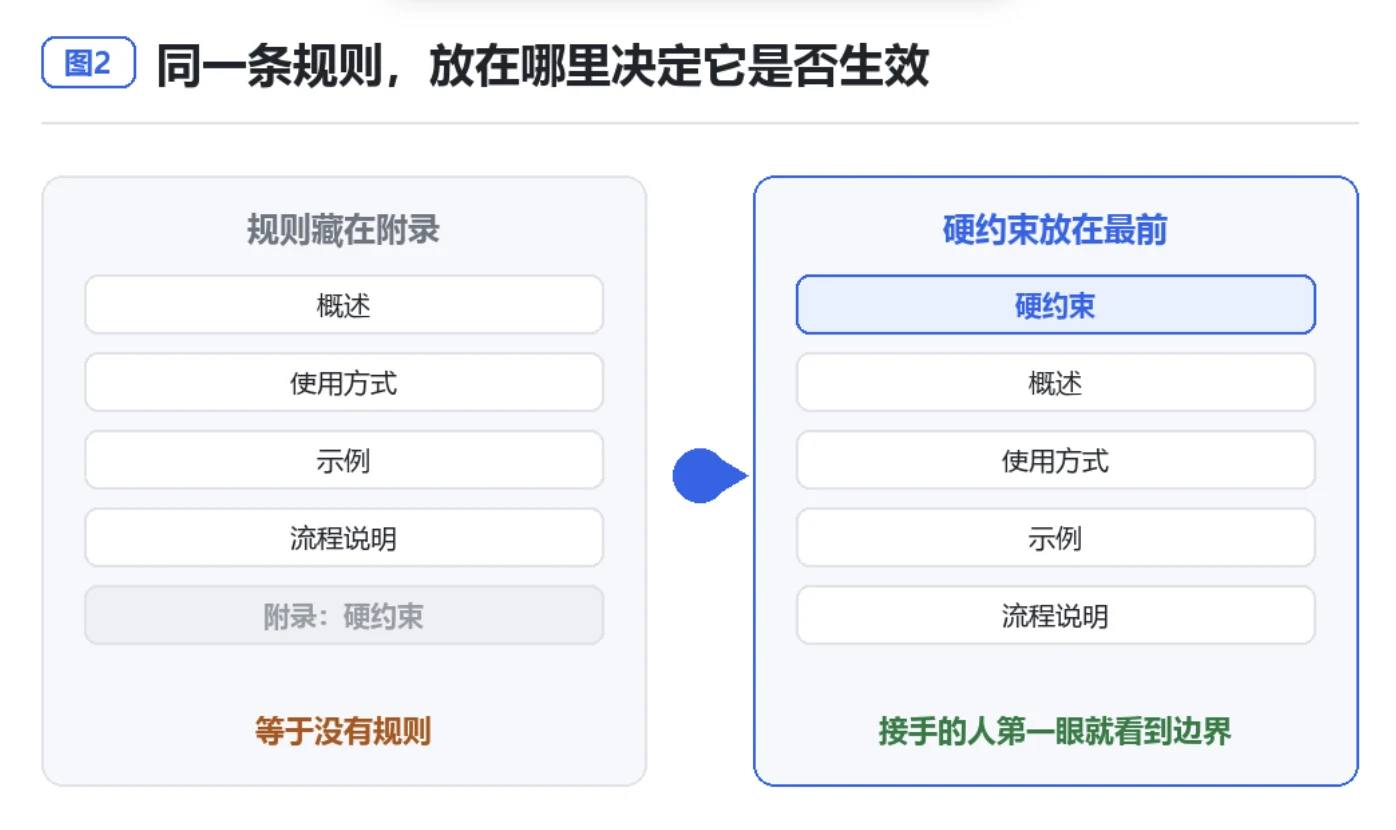
第三道:硬约束前置解决的是规则被忽略的问题。不可违反的条款集中在文档最前面。放进附录的规则等于没有规则。我的硬约束里有一条,信息不足时先追问,不允许用默认值绕过去。它放在最前面,接手的人第一眼就知道边界在哪,不必往后翻才发现自己越了界。
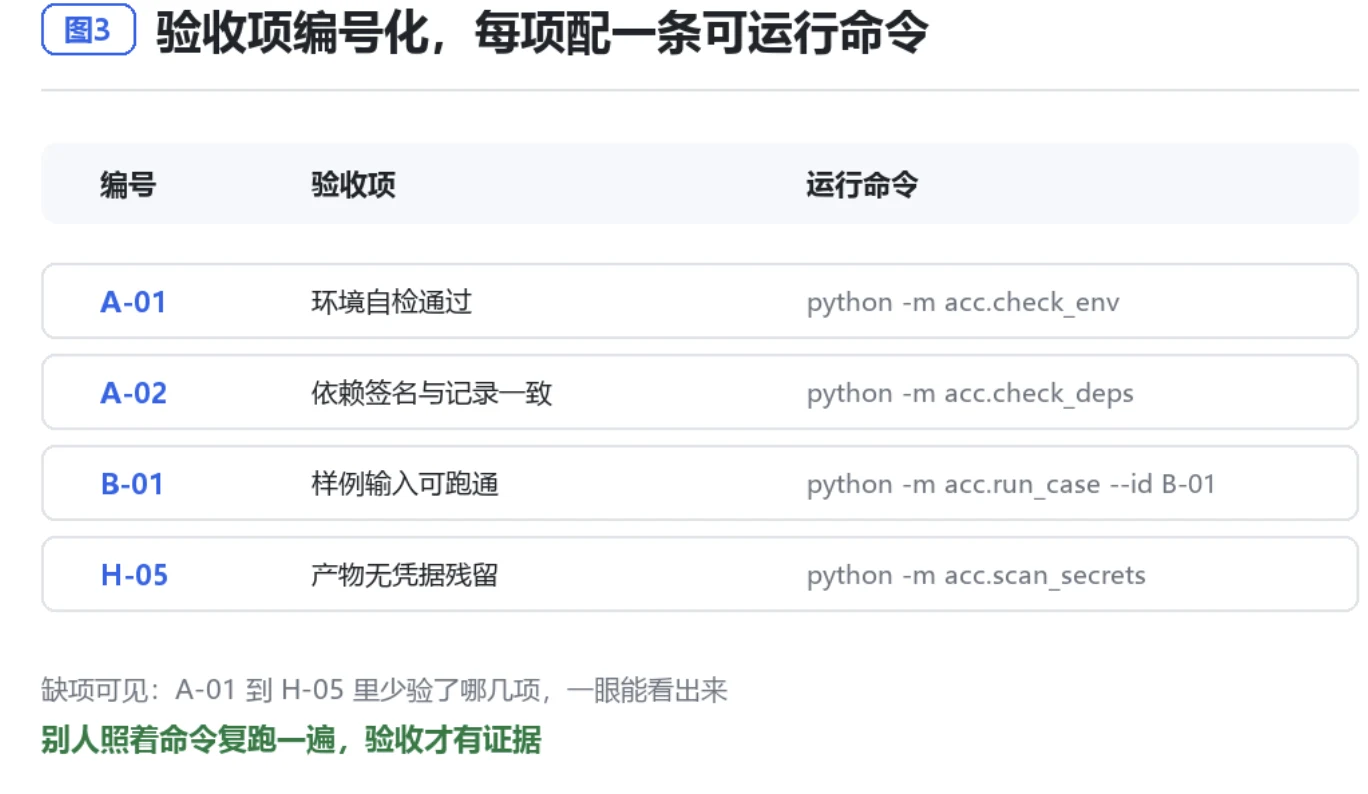
第四道:验收编号化解决的是可证明的问题。验收项写成 A-01 到 H-05 这样的编号,每一项后面跟一条能直接跑的运行命令。别人照着命令复跑一遍,验收就有了证据。编号还有一个附带作用,缺项是可见的,少验了哪几项一眼能看出来,不必等人问一句你都测过什么。
三、宁可不出结论,也不出错误结论
四道措施管的是理想情况。实际交付里还有一类问题,某个组件就是无法启动。它不常发生,但一旦发生,决定的是这一轮评测值不值得信。
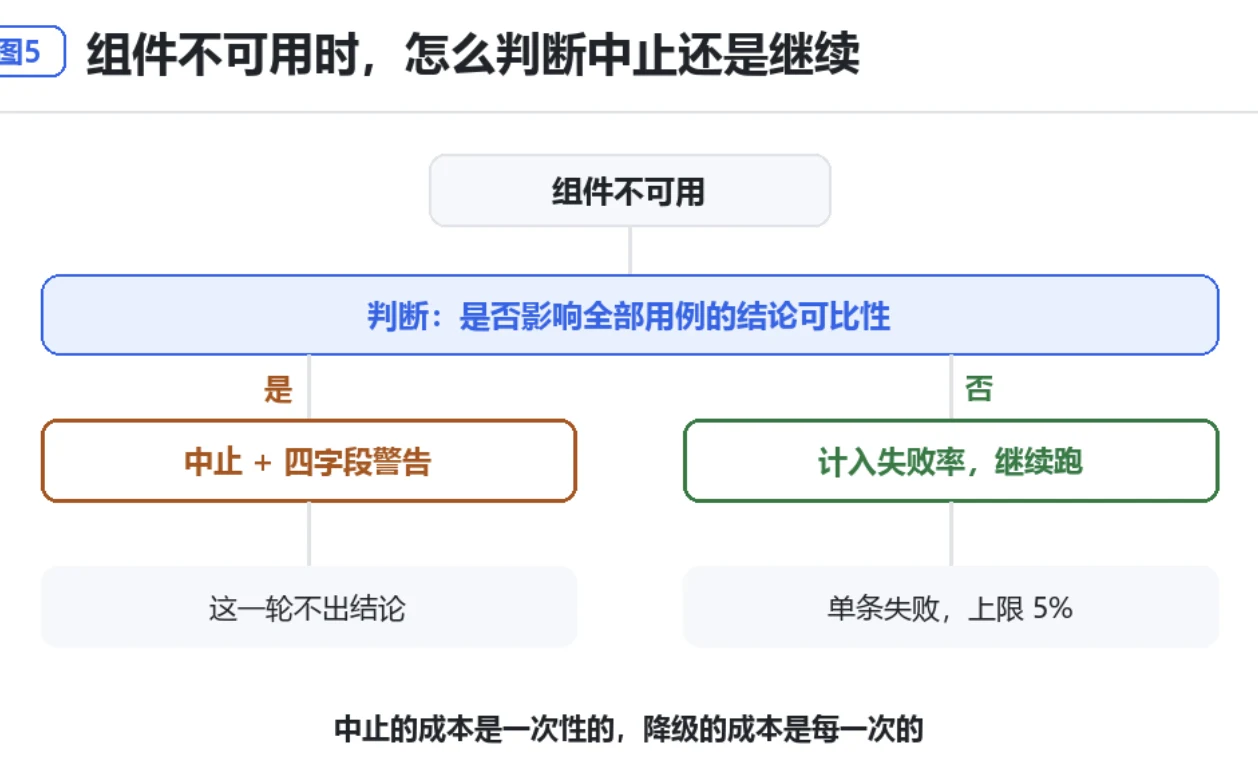
我的兜底策略是零降级。组件真不可用时中止流程,并给出四字段警告,不可用项、影响范围、用户需要做什么、之后怎么复检。前两项说清事实,后两项给出动作。
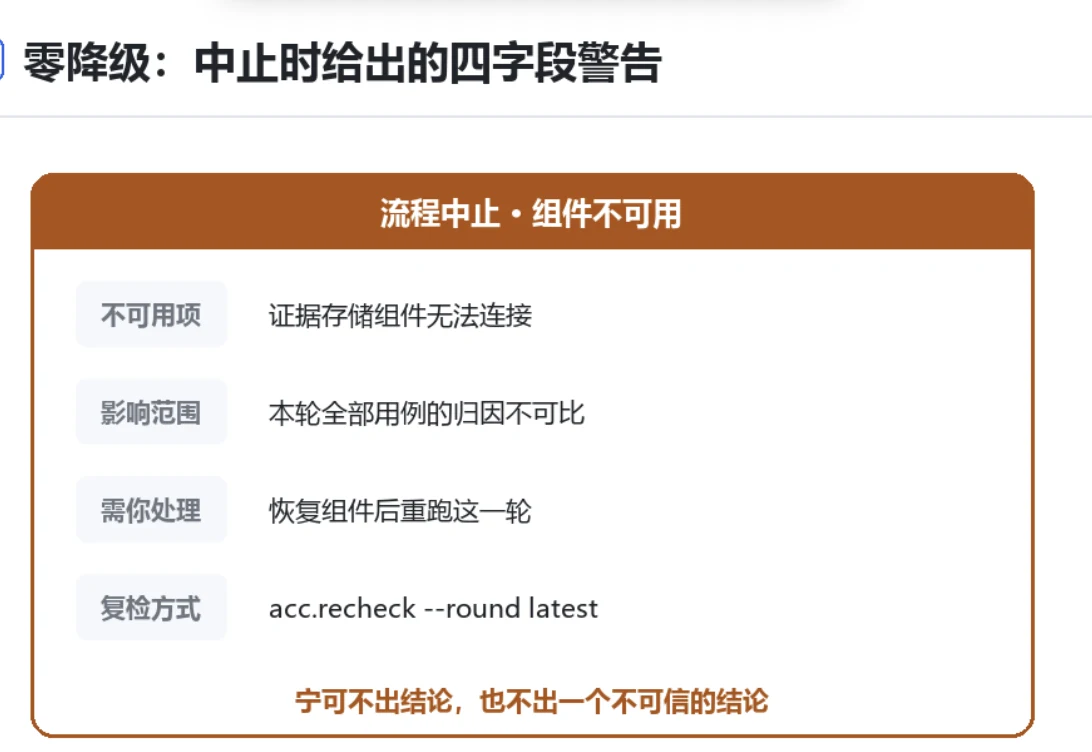
这个选择来自一次实际的失败。当时我在做agent自动化评测 Langfuse 容器挂了,脚本如果「聪明」地降级、改用内存里那份证据,最后得到的归因完全无法回溯。数据看着是齐的,结论是悬空的,这一轮评测就白做了。从那次起,我把零降级写死。
降级表面上对用户更友好,代价是把判断成本推给下游。拿到一份缺证据的结果,你没法确认它可信,还得回头重跑。
我宁可不出结论,也不出一个不可信的结论。
四、最常被追问的三个问题
第一:别人跑不起来,最常见的原因是什么?
我总结是三个,解释器或依赖版本不对、外部服务没起、没给必要输入就硬跑。第一条我踩过。第二条是我自己部署 Langfuse 时忘了起容器。第三条我用规则堵掉了,信息不足先追问,不允许默认值绕过。这三条有个共同点,程序不会立刻停下,反而会继续跑出一个看起来正常的结果。这类问题最难排查。
第二:如果组件真不可用呢?
零降级,中止加四字段警告。上面 Langfuse 那次实测,就是这条策略的由来。
第三:这样是不是设置的太严?
我区分两种情况,不是一刀切。影响全部用例结论可比性的,我中止;只影响单条用例的,我计入失败率继续跑。
如果你手上也有要交付的产物,可以先做一个最小的验证,把它交给一个没参与过的人,让他照着文档跑一遍。他卡住的任何地方,就是你还没交付的部分。