什么叫答得好?模型只是最显眼的背锅位
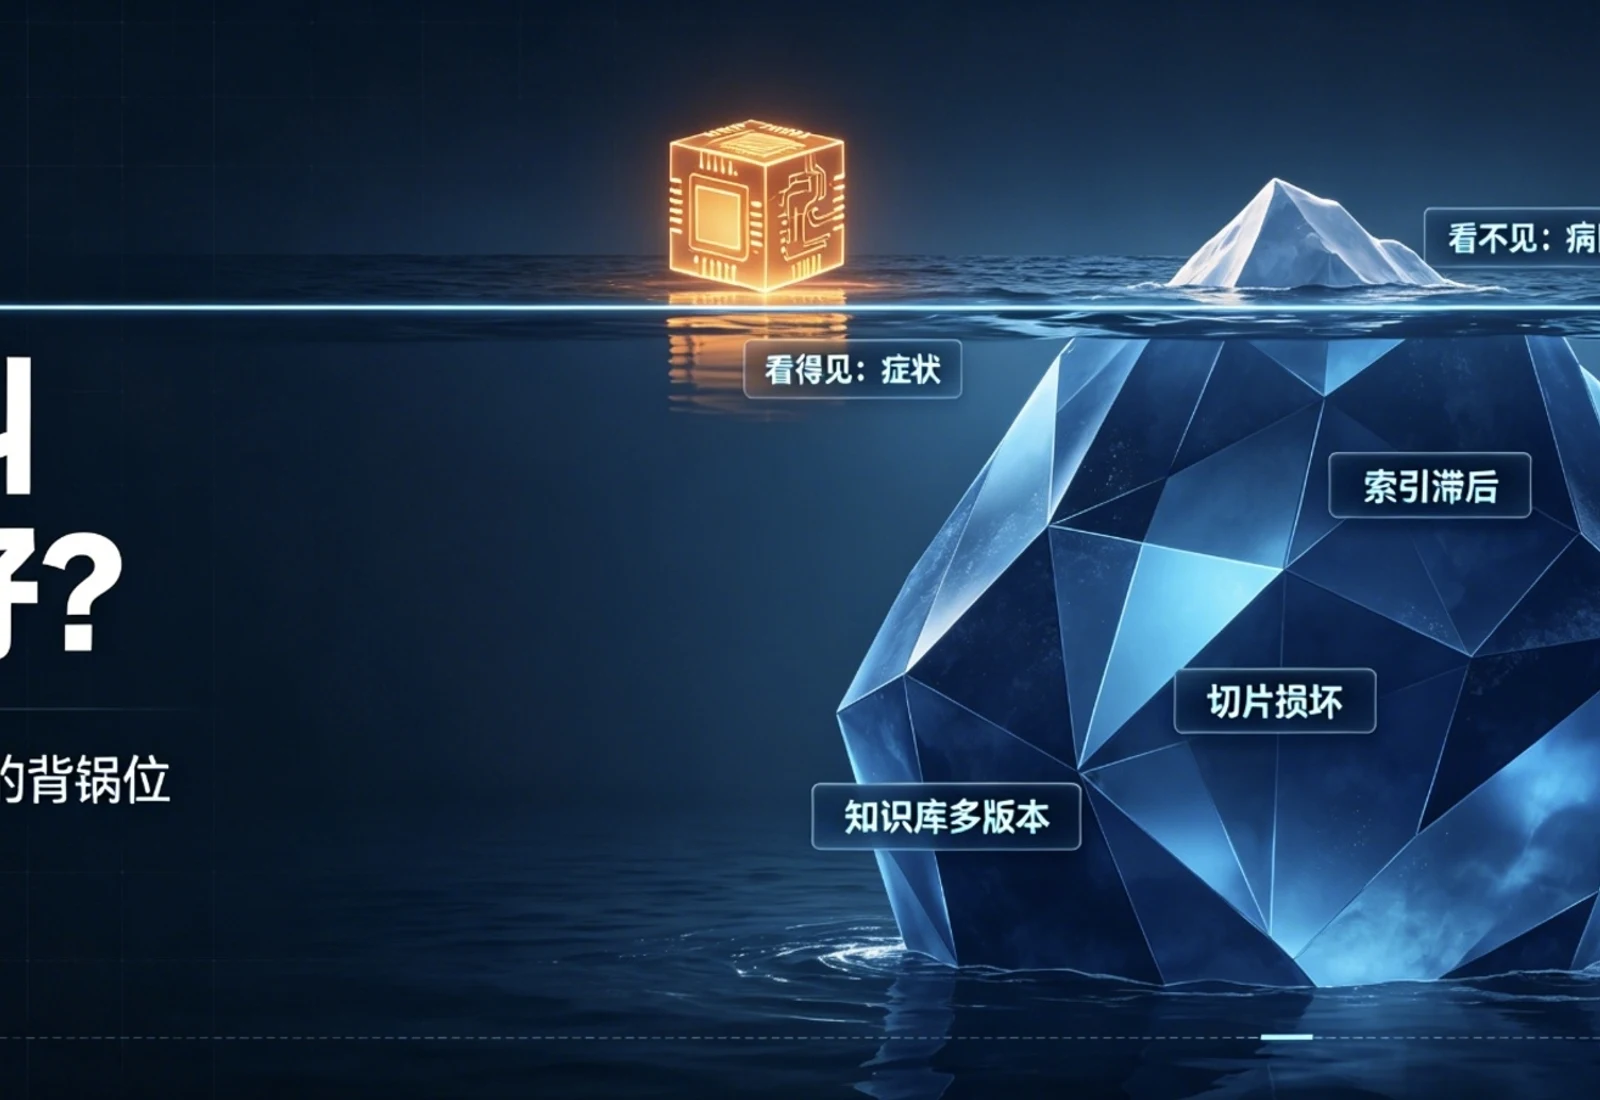
在我经历过的几个知识库问答的落地项目,卡住进度的地方从来不在模型选型,而在一件更基础的事上:普遍认知上大家都在关注怎么做提示词、工作流、agent设计,而好像没有人定义过什么叫 “答得好”。
下面分享一下我在Agent实际落地过程中对此的一些思考:
一、模型是最显眼的背锅位,但问题通常不在模型
模型在运行过程中的每一项都可非常易于观测,延迟、token 消耗、每一轮完整回答,全部有日志可查。检索层多数时候跑在黑盒里,出了问题连"那次请求究竟召回了哪几篇文档"都答不上来。看得见的地方出症状,看不见的地方出病因,排查精力自然会向症状一侧倾斜。
公开实测数据支持这个判断。单路检索存在天花板:纯向量检索的召回 约为 78%,纯 BM25 约为 65%,两路经过 RRF 融合后可以提升到约 91%,检索盲区是结构性的,靠调生成阶段的模型是无效的。。
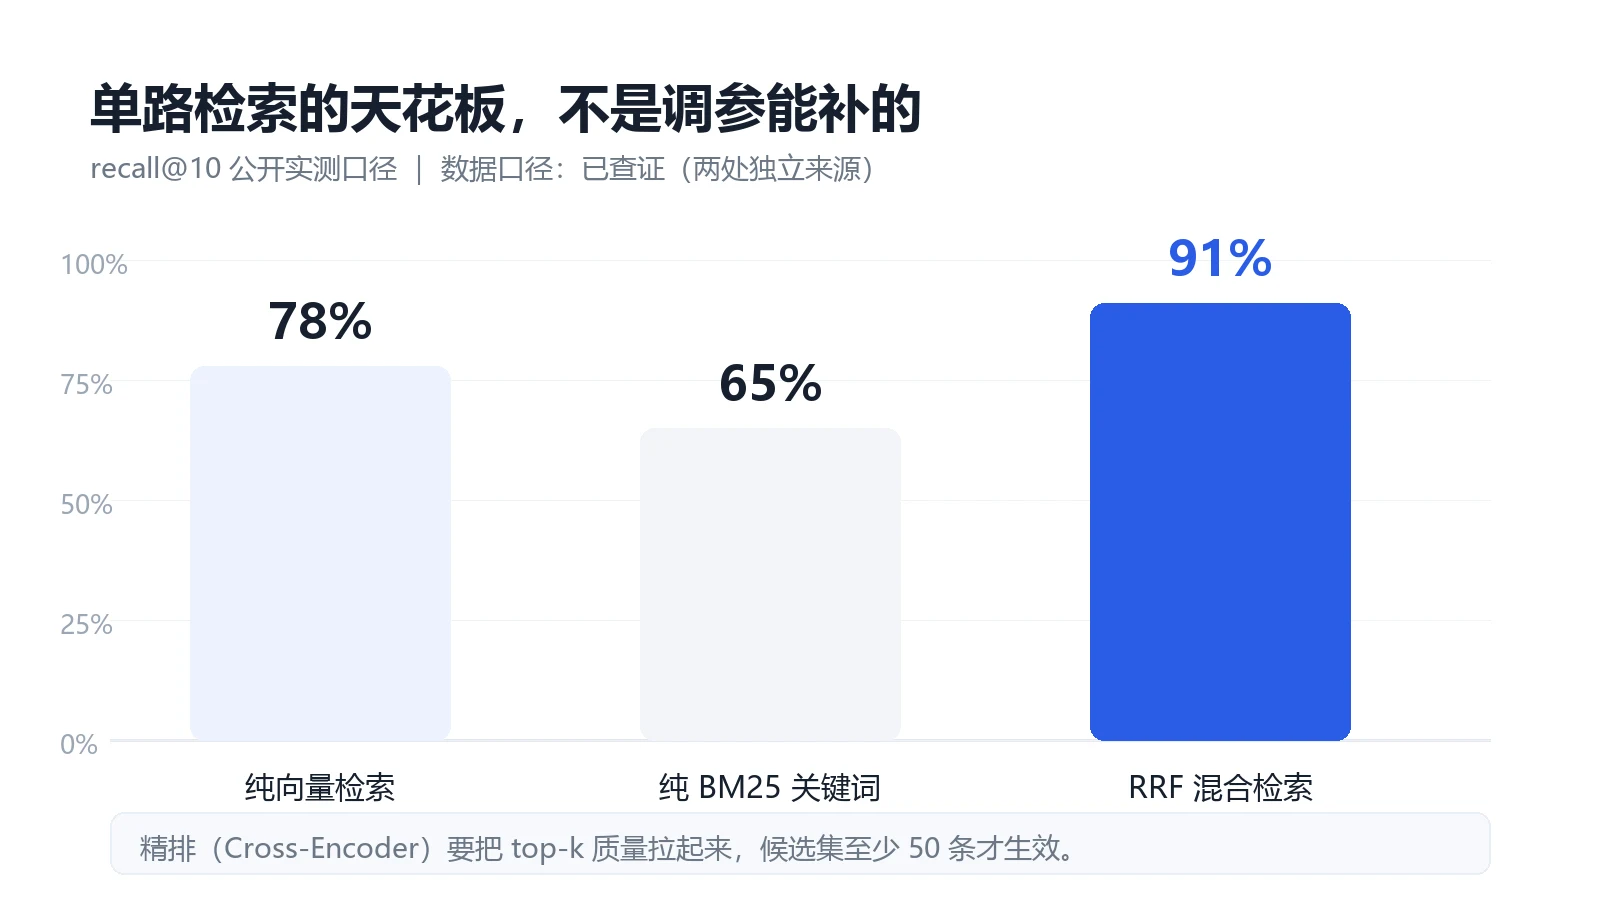
更麻烦的是精排。Cross-Encoder 精排能把 top-k 的质量拉起来,但候选集至少要有 50 条它才生效,候选给少了等于白装。这套两阶段检索的常规开销是:召回取 50 到 100 条,约 10 到 50 毫秒;精排留下 5 到 10 条,约 100 到 500 毫秒。相对于大模型几百毫秒到两秒的生成时间,这部分几乎可以忽略,因此效果上最划算的投入,往往不在模型那一层。
把检索失败拆开看,形态其实不多,我实践总结了几个常见的:
①原文档改了,索引没跟上:助手还在引用旧政策,模型拿到的切片本来就是错的,答案自然跑偏。
②表格被切坏了:切片恰好把表格和表头切成了两半(各类文件格式中都存在),取到的片段虽然来自正确的文档,给出的却是误导性答案。
③最隐蔽的一种 —— 每个环节单独看都没问题,结果却错了:比如同一份定价表在知识库里存着三个版本,检索时却没有任何 "哪个最新、哪个有权威性" 的信号可供参考;又比如嵌入模型悄悄换过、入库任务中途失败等。
二、更隐蔽的问题:知识库本身
被低估的不只是检索,知识库本身的问题更隐蔽。我遇到过最典型的一幕:库里明明有那份理财产品的费率说明,检索上来的却是去年的旧版本 —— 两份文档标题几乎一样,只有生效日期不同,然而生效日期在文中仅有落款处明文标识。而制度上没有任何一条规则说清 "到底以哪份为准",于是 AI 只能随机挑一份,再用非常确定的口气讲出来。
所以换模型为什么常常无效?因为模型拿到的仍然是错误的那几段上下文 —— 换一个更强的模型,它只是把错误回答得更流利了。根子不换,症状永远在。
二、先把“什么算好”写下来,再谈怎么调
我在项目里吃过一次亏,Agent测试时候回答都对,但一投产使用投诉率飙升,这里其实在一开始开发过程中就有相当一部分并未真正解决,只是被绕开了。
后来我调整了一件事:
把评估标准调整并做合理定义,并由甲方签字确认,按效果付费的合同结构下,乙方有把指标做得好看的动机,而有动机不等于会造假,只是选择空间的偏向。拦截率可以通过收紧兜底话术拉高,解决率可以通过放宽转人工口径拉高,两种做法都不违规,都会体现在周报里。标准一旦由甲方签字,讨论就会从"这周涨了多少"回到"这条问题算不算被解决",后者才有复算的可能。
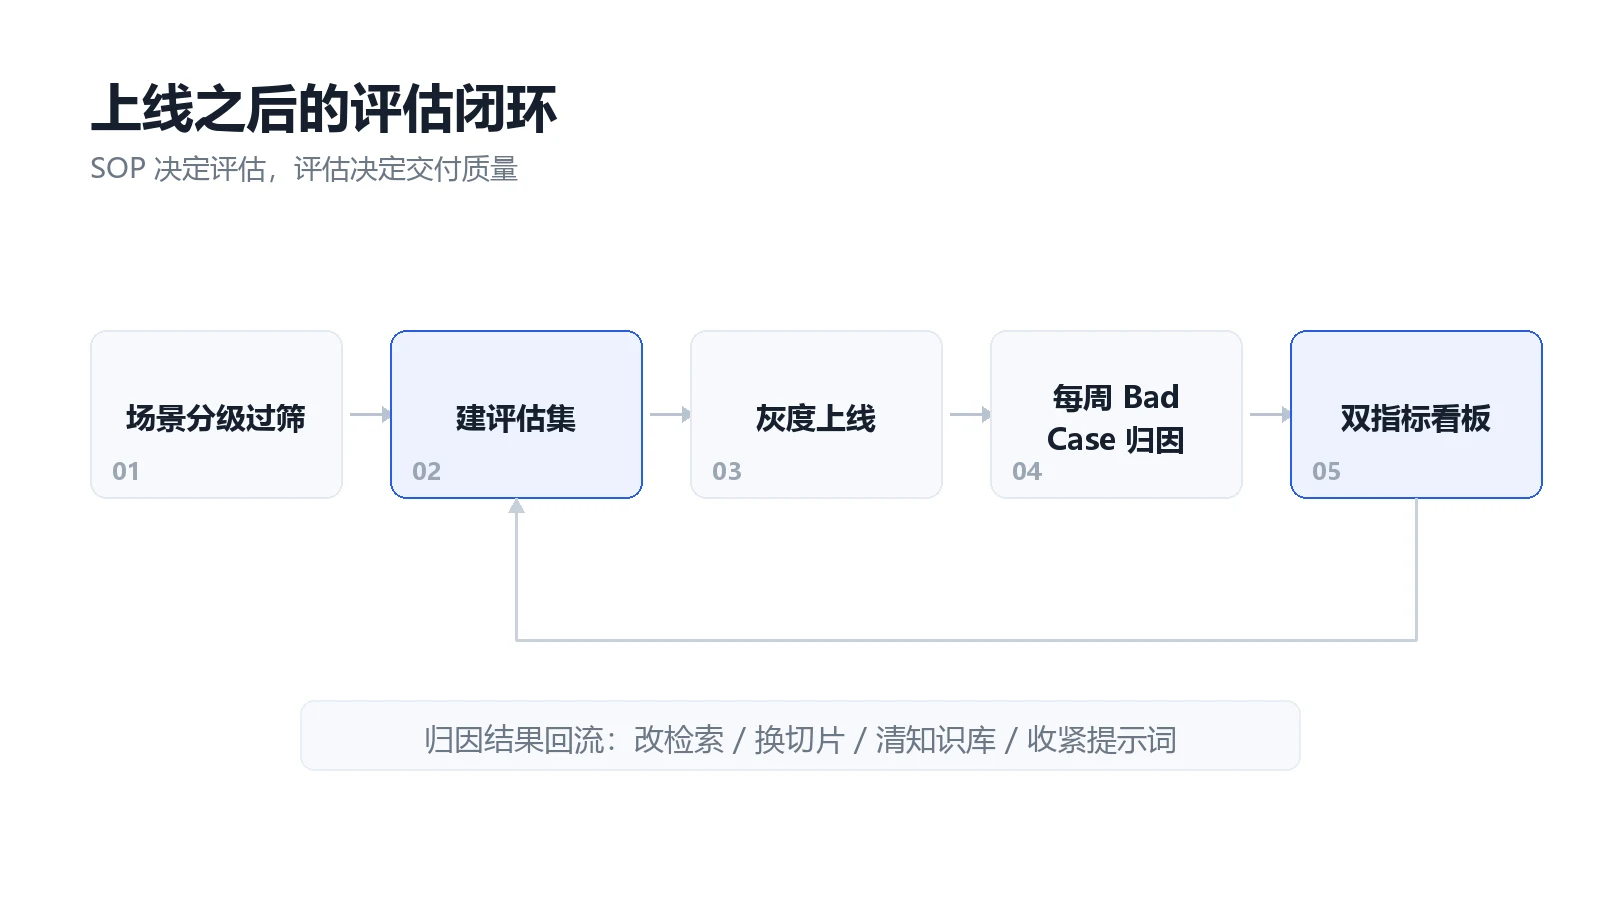
场景分级表用三个条件做筛选:
这个问题是否高频、是否已有标准处理流程、出错是否可容错。三个条件同时满足的场景才交给 AI回答,而涉及敏感信息、承诺、金额、合规口径的场景,宁可直转人工,后续本地测试通过后再灰度放开。
评估集与归因机制是第二样。评估集从真实历史工单里抽,人工标出标准答案与可接受范围,灰度前和上线后各跑一次,作为唯一的效果基线。Bad Case 每周归因一次,且只允许归入四类:检索没召回、召回错了切片、无符合知识库、生成逻辑错误。归入"模型不行"是不被接受的,因为那条归因推导不出任何具体动作,而另外四类各自对应一个明确的改动位置如
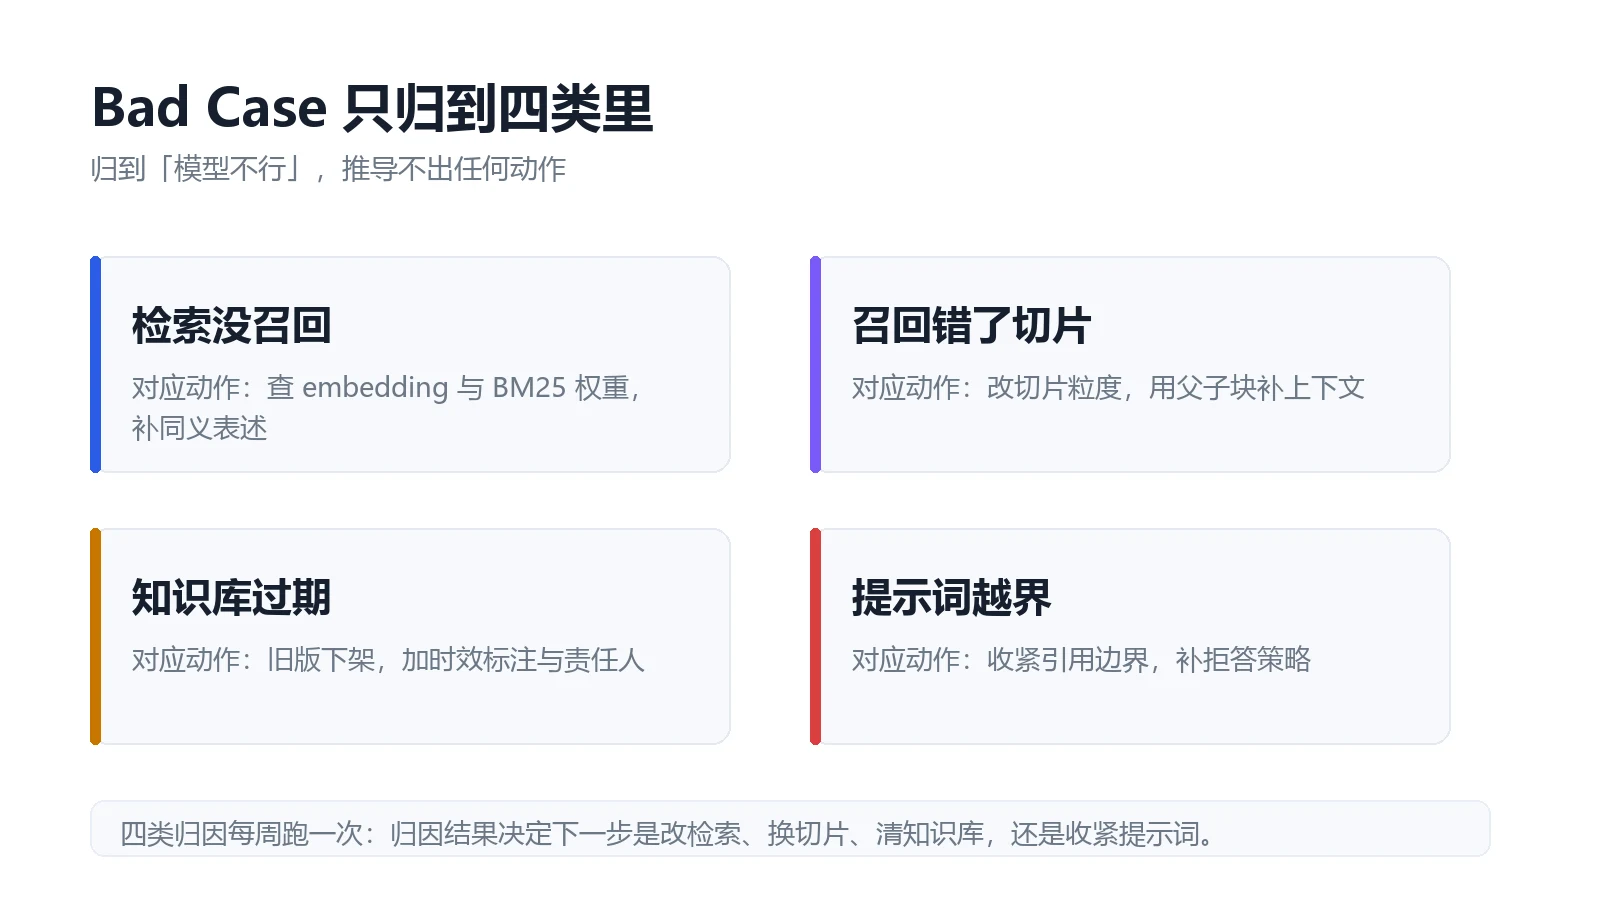
Bad Case 只归到四类里,每一类对应一个动作
灰度上线这一步要按场景切,而不是按流量切。
按流量切的做法很常见:一半用户走 AI、一半走人工,然后对比两边指标。问题是两个流量池的用户构成与问题构成并不相同,最后看到的差异可能全部来自样本偏差。
按场景切的逻辑是,每次只把已经过筛的一个场景放进 AI,观察它的归因分布,稳定后再放下一个。这样做上线周期更长,但每一次扩量都有明确的判断依据,出问题也能定位到具体场景,而不是笼统的"最近效果变差了"。
双指标看板是第三样。拦截率和解决率必须同屏,单看任意一个都会骗人:拦截率上去了,可能只是把问题挡在门外,用户的问题并没有被真正解决。解决率上去了,可能只是转人工转得勤。转人工率只作异常监测,不列为 KPI。一旦它变成 KPI,团队就会去优化那个数字,而不是优化用户是否被解决。
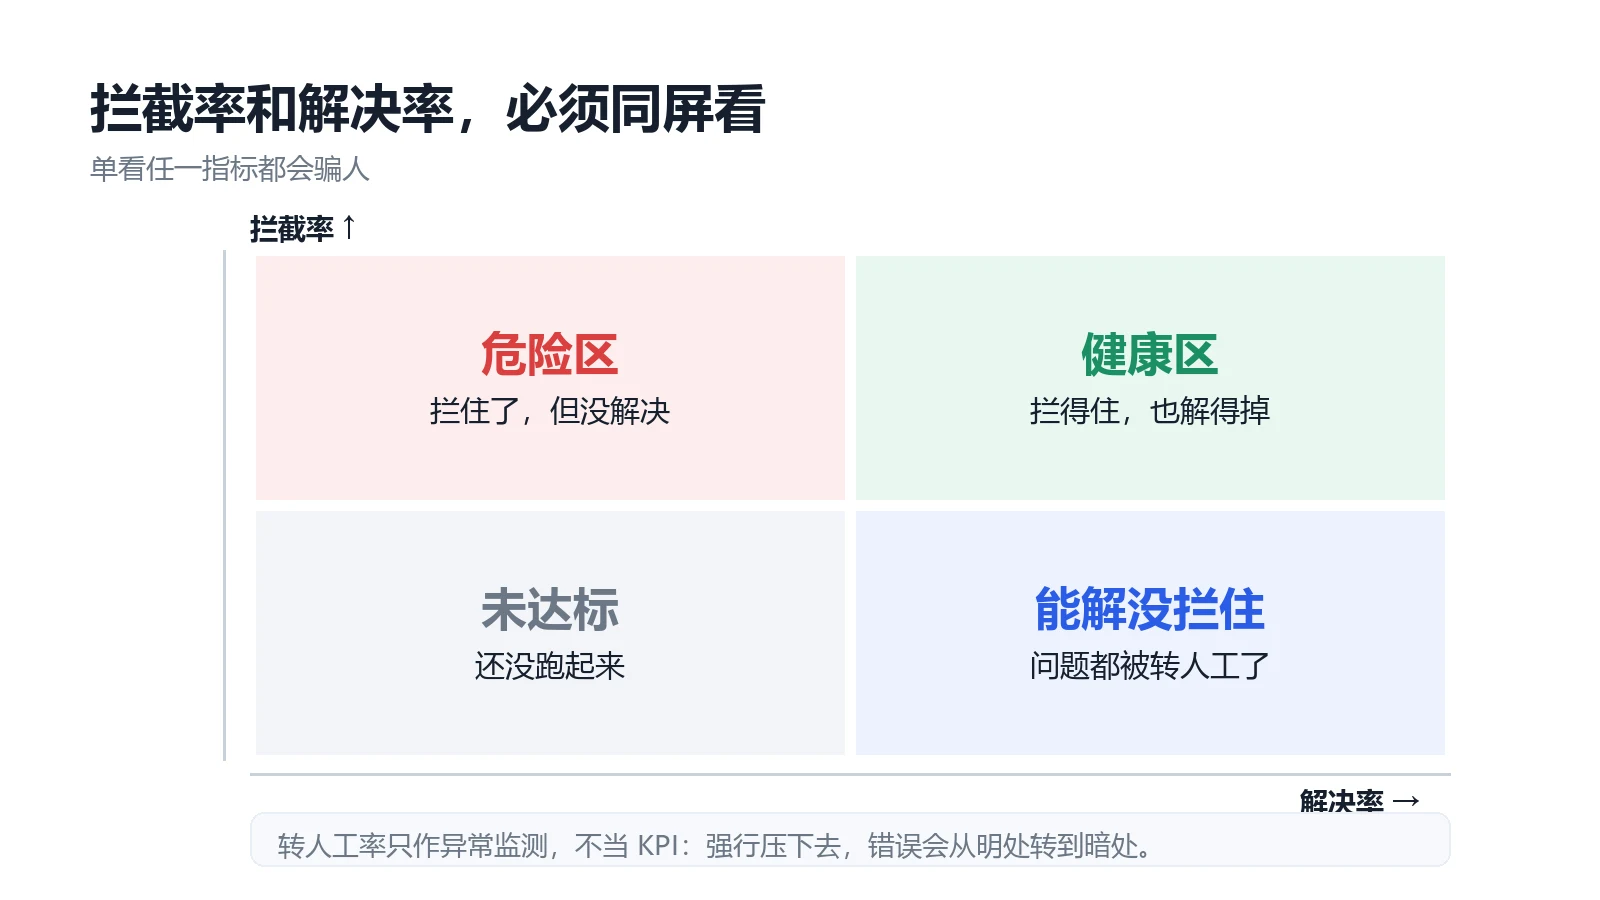
拦截率 × 解决率:右上才是健康区,左上是最容易被忽视的危险区
三、总结
还是回到开头那句话:真正让人不安的,从来不是答错本身,而是没有人说得清这一版究竟比上一版更好,还是更差,问题出在哪个环节,这个环节是否得到了实际的优化,可能放在测试中一个样实际灰度投产了又是一个样。
这几年的项目做下来,我越来越确认一件事:模型是最显眼的背锅位,但其实真正的问题通常不在模型。检索有结构性的盲区,知识库有多版本和时效性的特点,这些藏在黑盒里的环节才是真正的病灶 —— 换一个更强的模型,它只是把错误回答得更流利了。
所以真正值得投入的,从来不是下一次模型升级,而是先把 "什么算好" 这件事写下来,白纸黑字,业务方签字。标准一旦成立,讨论就会从 "这周涨了多少" 回到 "这条问题算不算被解决",后者才有复算的可能。后面那些评估集、归因、灰度、看板,说到底都只是在为这份标准服务 —— 让每一次改动有据可依,让 "变好了" 这件事不再靠感觉。
模型会持续变强,检索方案也会持续变化。唯一不变的,是那份的定义好坏的标准。它不保证你一定做对,但它保证,三个月后面对任何质疑,你手里都有一把尺子。